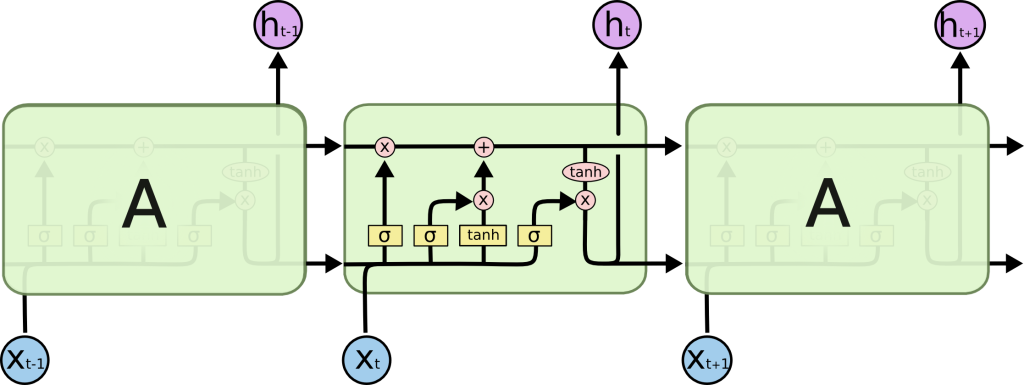

LSTM(Long Short-Term Memory)은 순환 신경망(Recurrent Neural Network, RNN)의 한 종류로서, 시퀀스 데이터 (시계열 데이터, 텍스트 등)를 처리하기 위해 신경망 입니다. 이전에 배운 것들을 기억할 수 있도록 컴퓨터 의 “일기장” 을 바로 LSTM 이라고 할 수 있습니다. 즉, “일기장”을 찾아보면서 이전에 무슨 일이 있었는지 확인을 할 수 있으며 미래에 무슨 일이 일어날지 예측을 할 수 있습니다. … 계속 읽기 “기억하는 신경망 LSTM(Long Short-Term Memory), 어떻게 작동할까?”
요즘 ChatGPT 의 번역 능력이 너무 좋아서 가끔 “이게 진짜 사람이랑 뭐가 다르지?” 싶은 순간이 많습니다. 영화나 원서 번역 실무현장에서도 실제로 많이 사용되고 있죠. 그런데 이 모델들은 어떻게 이렇게 방대한 지식을 쌓고 발전할까요? 그냥 인터넷에 있는 내용을 긁어다가 정리하는 걸까요? 아니면 진짜로 무언가를 배우고 기억하는 걸까요? 1. LLM의 기본 원리 1) 텍스트를 숫자로 바꾸는 첫걸음: … 계속 읽기 “대형 언어 모델(LLM)의 작동 원리와 학습 과정”
Deep Learning 은 인간의 뇌에서 영감을 받은 인공 신경망을 사용하여 컴퓨터가 학습하는 머신 러닝 의 방법 중 하나로, 음악을 만들거나,우리가 오렌지와 사과를 보고 각각 다른 과일이라고 인식할 수 있는 것 처럼 컴퓨터가 사진이나 사물을 보고 이해할 수 있거나 언어를 이해하는 방법을 학습 하는 것이라고 정의할 수 있습니다.’Deep’ 이라는 단어는 신경망에 여러 층(레이어)을 쌓아 깊게 만든다는 의미입니다. 이러한 깊은 네트워크를 통해 컴퓨터는 복잡한 문제를 해결하는 데 필요한 패턴이나 관계를 스스로 찾아낼 수 있습니다. 딥러닝은 이미지 인식, 음성 인식, 자연어 처리 등 다양한 분야에서 활용되고 있습니다.
머신러닝 알고리즘은 데이터에서 패턴을 찾아내어 예측을 하거나 분류하는 등의 문제를 해결합니다. 지도학습은 레이블이 있는 데이터 셋을 통해 알고리즘으로 데이터를 구별하는 판별식을 만든 후 새로운 데이터가 어떠한 결과를 출력하는지 알아내는 학습 모델 입니다. 즉, 지도학습은 과거의 데이터를 학습해서 결과를 예측하는 방법 입니다. ‘지도학습’ 에 해당되는 세 가지 머신러닝 알고리즘 – KNN(K-Nearest Neighbors), 서포트 벡터 머신(Support Vector … 계속 읽기 “KNN, 서포트 벡터 머신, 의사결정 트리”
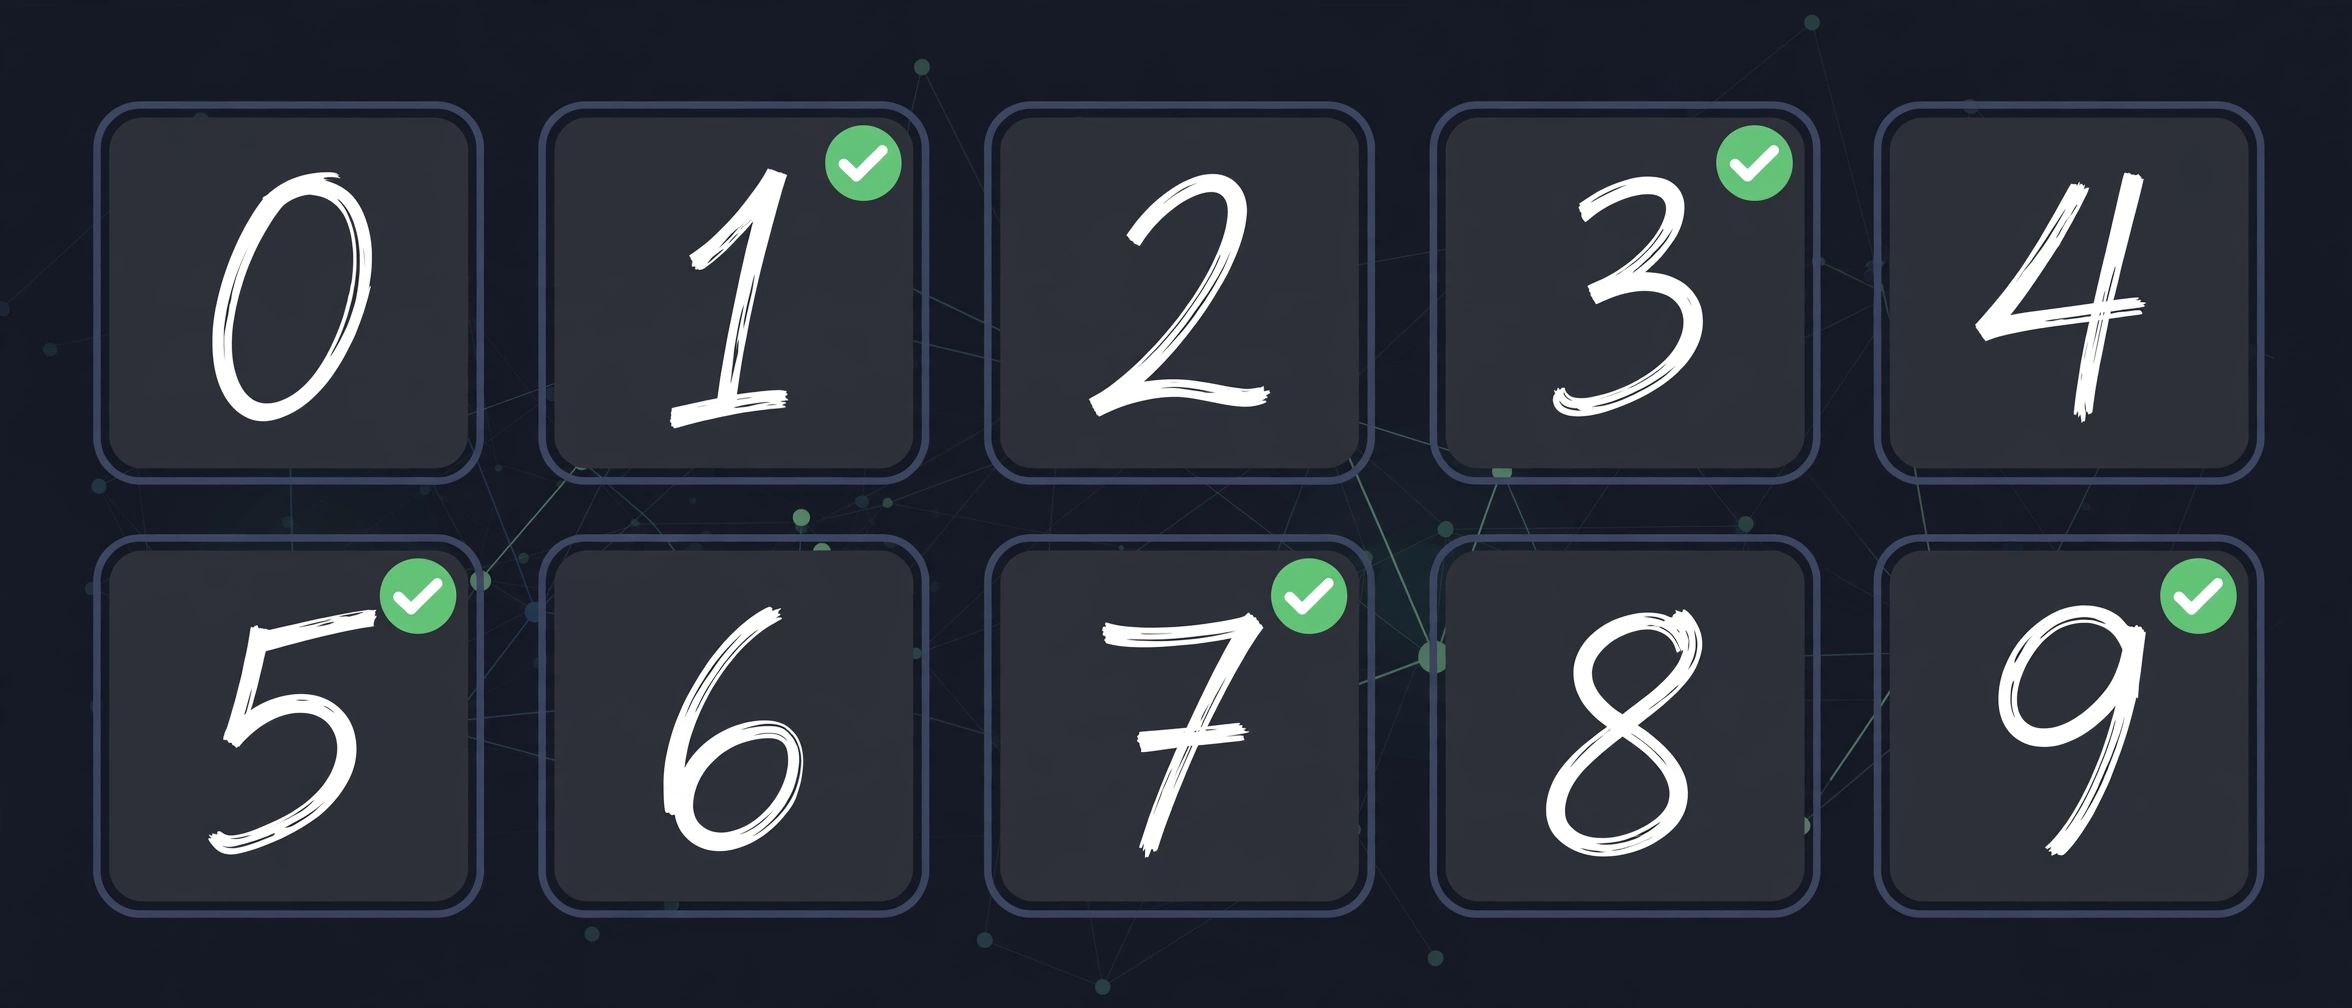
MNIST는 ‘Modified National Institute of Standards and Technology’의 약자로, 미국의 표준 기술 연구소에서 생성된 원래의 NIST 데이터셋을 수정하여 만들었습니다. 이 데이터셋은 손으로 쓴 숫자들의 이미지를 포함하고 있습니다. 이 데이터셋은 기계 학습 분야의 연구에 널리 사용되며, 특히 이미지 처리를 위한 벤치마크로 사용됩니다.
Iris 데이터셋은 통계학과 머신러닝에서 자주 사용되는 데이터셋 중 하나입니다. 이 데이터셋은 붓꽃(Iris)의 품종을 분류하기 위한 데이터셋으로, 총 세 가지 품종(Setosa, Versicolor, Virginica)의 정보가 각각 50개씩 총 150개의 샘플로 구성되어 있습니다.