
머신러닝 입문자가 MNIST 다음으로 만나는 데이터셋, 바로 Iris(붓꽃)입니다. 단 150개의 데이터로 분류 모델의 전체 흐름을 배울 수 있는 가장 작은 교과서죠. 직접 코드를 돌려 93.3% 정확도를 확인해봅니다.
본 글은 2026년 10월 기준으로 작성되었습니다.
1. Iris 데이터셋이란?
1936년 Ronald Fisher가 소개한 고전 데이터셋으로, 붓꽃 3개 품종의 꽃잎·꽃받침 측정값 150개로 이루어져 있습니다. scikit-learn에 내장되어 있어 설치 없이 바로 쓸 수 있습니다.
| 항목 | 내용 |
|---|---|
| 전체 샘플 | 150개 (품종별 50개씩) |
| 품종 | Setosa, Versicolor, Virginica |
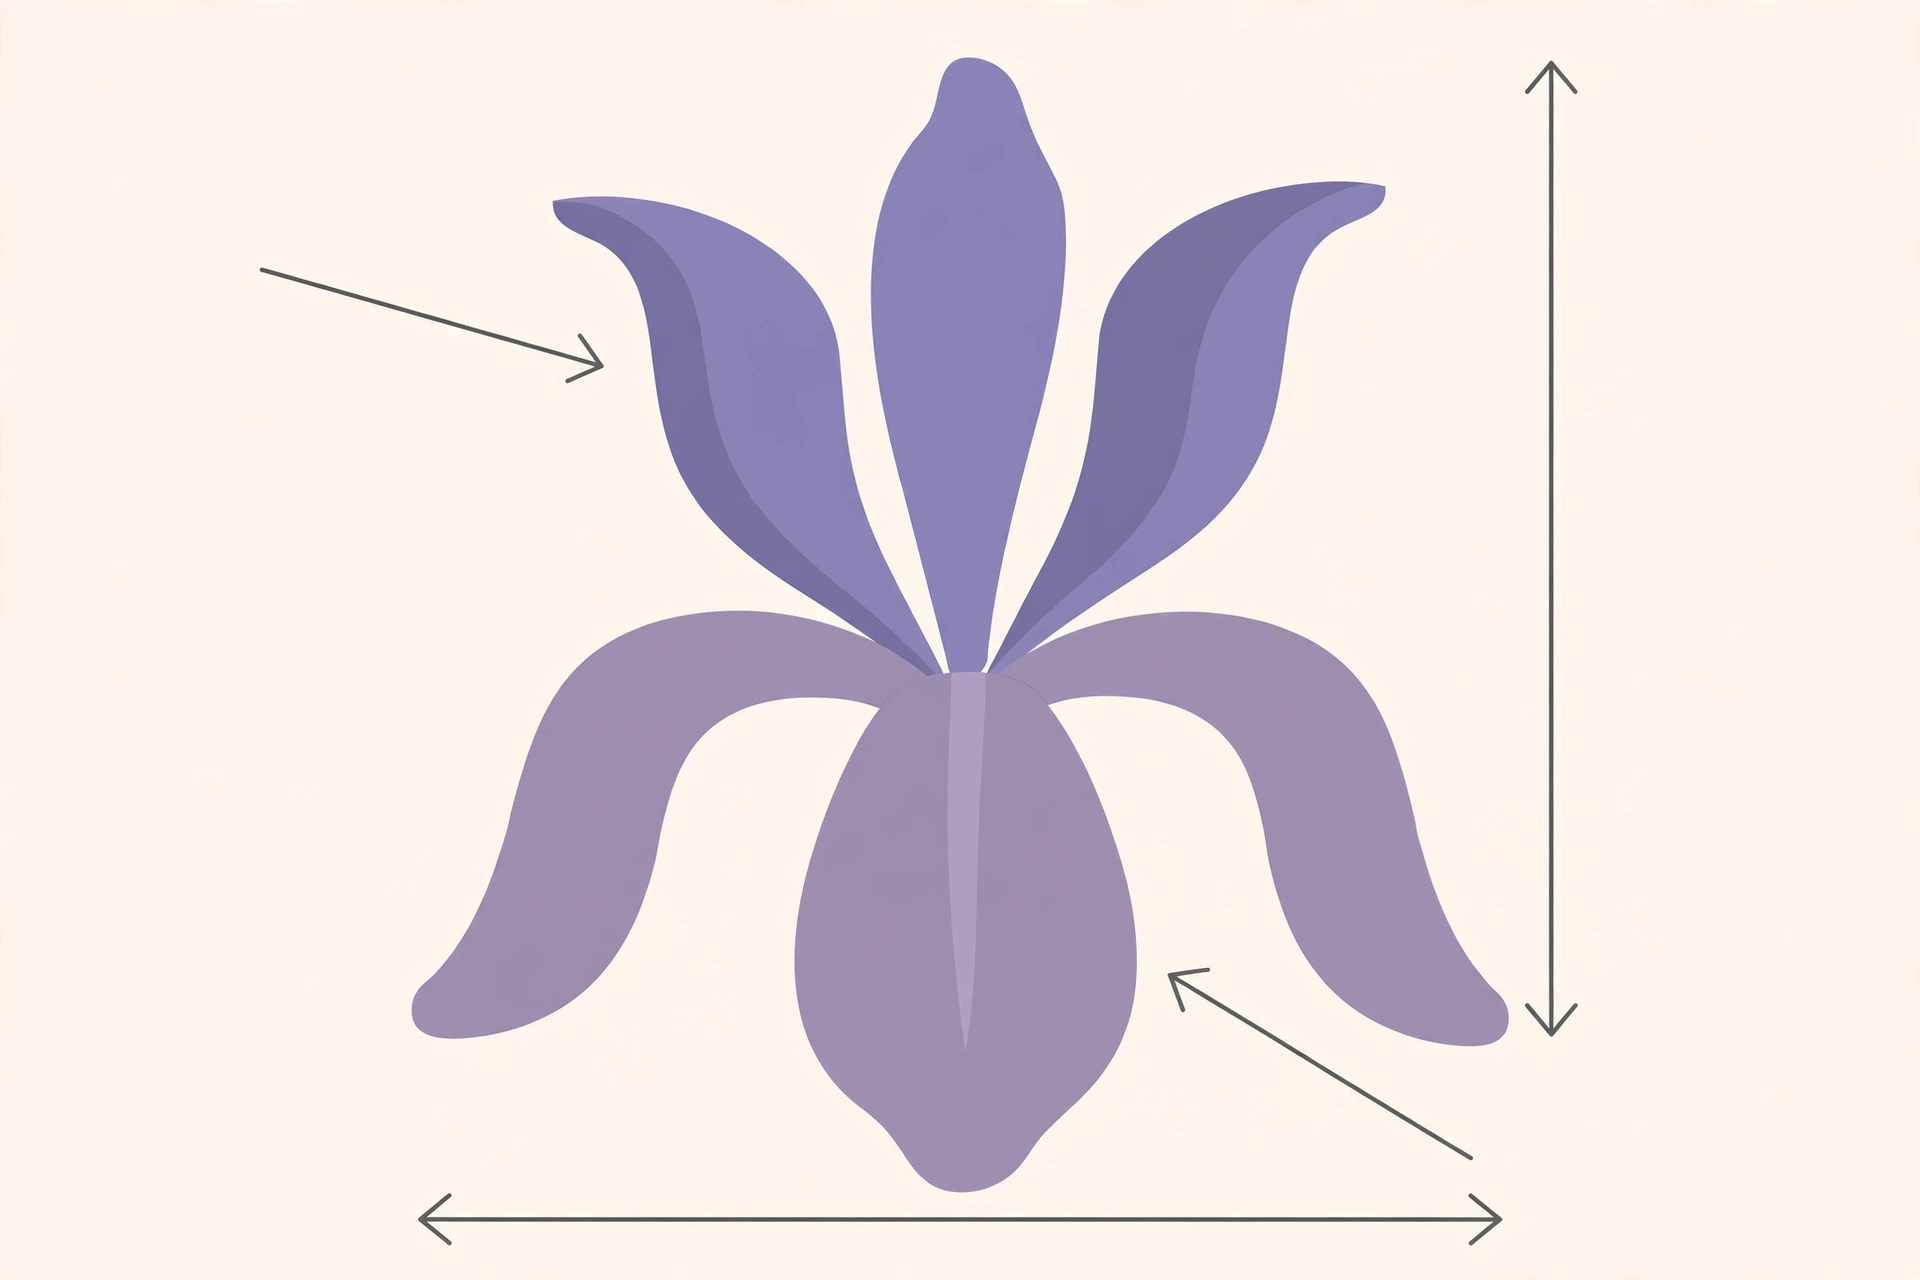
| 특성 4가지 | 꽃받침 길이·너비, 꽃잎 길이·너비 (cm) |
| 과제 형태 | 지도학습 — 측정값으로 품종을 맞추는 분류 문제 |
2. 왜 Iris인가
데이터가 작아서 1초 만에 학습이 끝나고, 특성도 4개뿐이라 결과를 눈으로 직접 확인할 수 있습니다. 아래 산점도처럼 꽃잎 길이·너비만 그려봐도 품종이 뭉치는 게 보이죠. 분류 모델의 개념(특성 → 결정 경계 → 예측)을 배우기에 이보다 좋은 예제가 없습니다.
3. 실전: 직접 돌려본 붓꽃 분류
아래는 실제로 실행한 결과입니다. 105개로 학습하고 45개로 테스트했습니다.
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

# Iris 불러오기 (내장 데이터셋, 150개)
iris = load_iris()
X, y = iris.data, iris.target

# 105개 학습 / 45개 테스트로 분리
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.3, random_state=42, stratify=y
)

model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
print("테스트 정확도:", model.score(X_test, y_test))
# 결과: 0.9333 (45개 기준)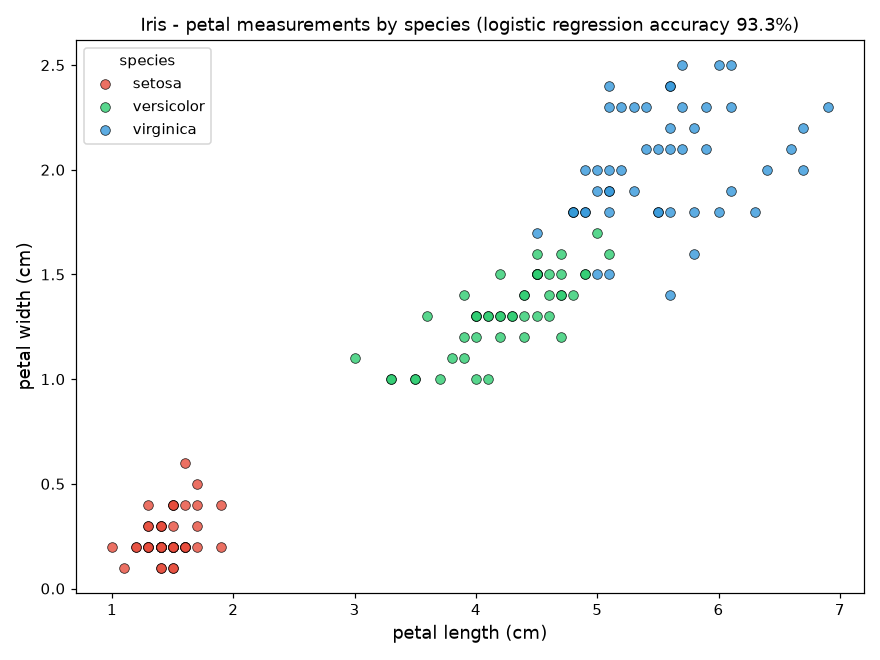
93.3%가 나왔습니다. 그래프를 보면 Setosa(빨강)는 완전히 따로 떨어져 있고, Versicolor(초록)와 Virginica(파랑)는 경계에서 살짝 겹칩니다. 모델이 틀리는 경우도 바로 이 겹치는 구간에서 나옵니다. 데이터가 눈으로 보이니 모델의 한계까지 직관적으로 이해되죠.
4. Iris로 시작하는 방법
scikit-learn만 있으면 됩니다. 별도 다운로드도 필요 없습니다.
pip install scikit-learn matplotlib위 실전 코드를 그대로 실행하면 같은 결과를 재현할 수 있습니다. load_iris() 한 줄이면 데이터 준비 끝입니다.
마무리
Iris는 “작지만 완전한” 분류 문제입니다. 데이터 불러오기 → 학습/테스트 분리 → 모델 학습 → 정확도 평가 → 시각화의 전 과정을 10줄 코드로 경험할 수 있습니다. 이 흐름을 익히면 MNIST 같은 큰 데이터셋도 같은 방식으로 접근할 수 있습니다.
📎 관련 글: MNIST Dataset에 대하여 — 손글씨 숫자를 분류하는 또 다른 대표 데이터셋입니다.