
머신러닝을 공부하다 보면 가장 먼저 만나는 데이터셋, 바로 MNIST입니다. “Hello World” 같은 존재죠. 이 글에서는 MNIST가 무엇인지, 왜 중요한지, 그리고 직접 코드를 돌려 얼마나 잘 맞추는지까지 확인해봅니다.
본 글은 2026년 10월 기준으로 작성되었습니다.
1. MNIST란?
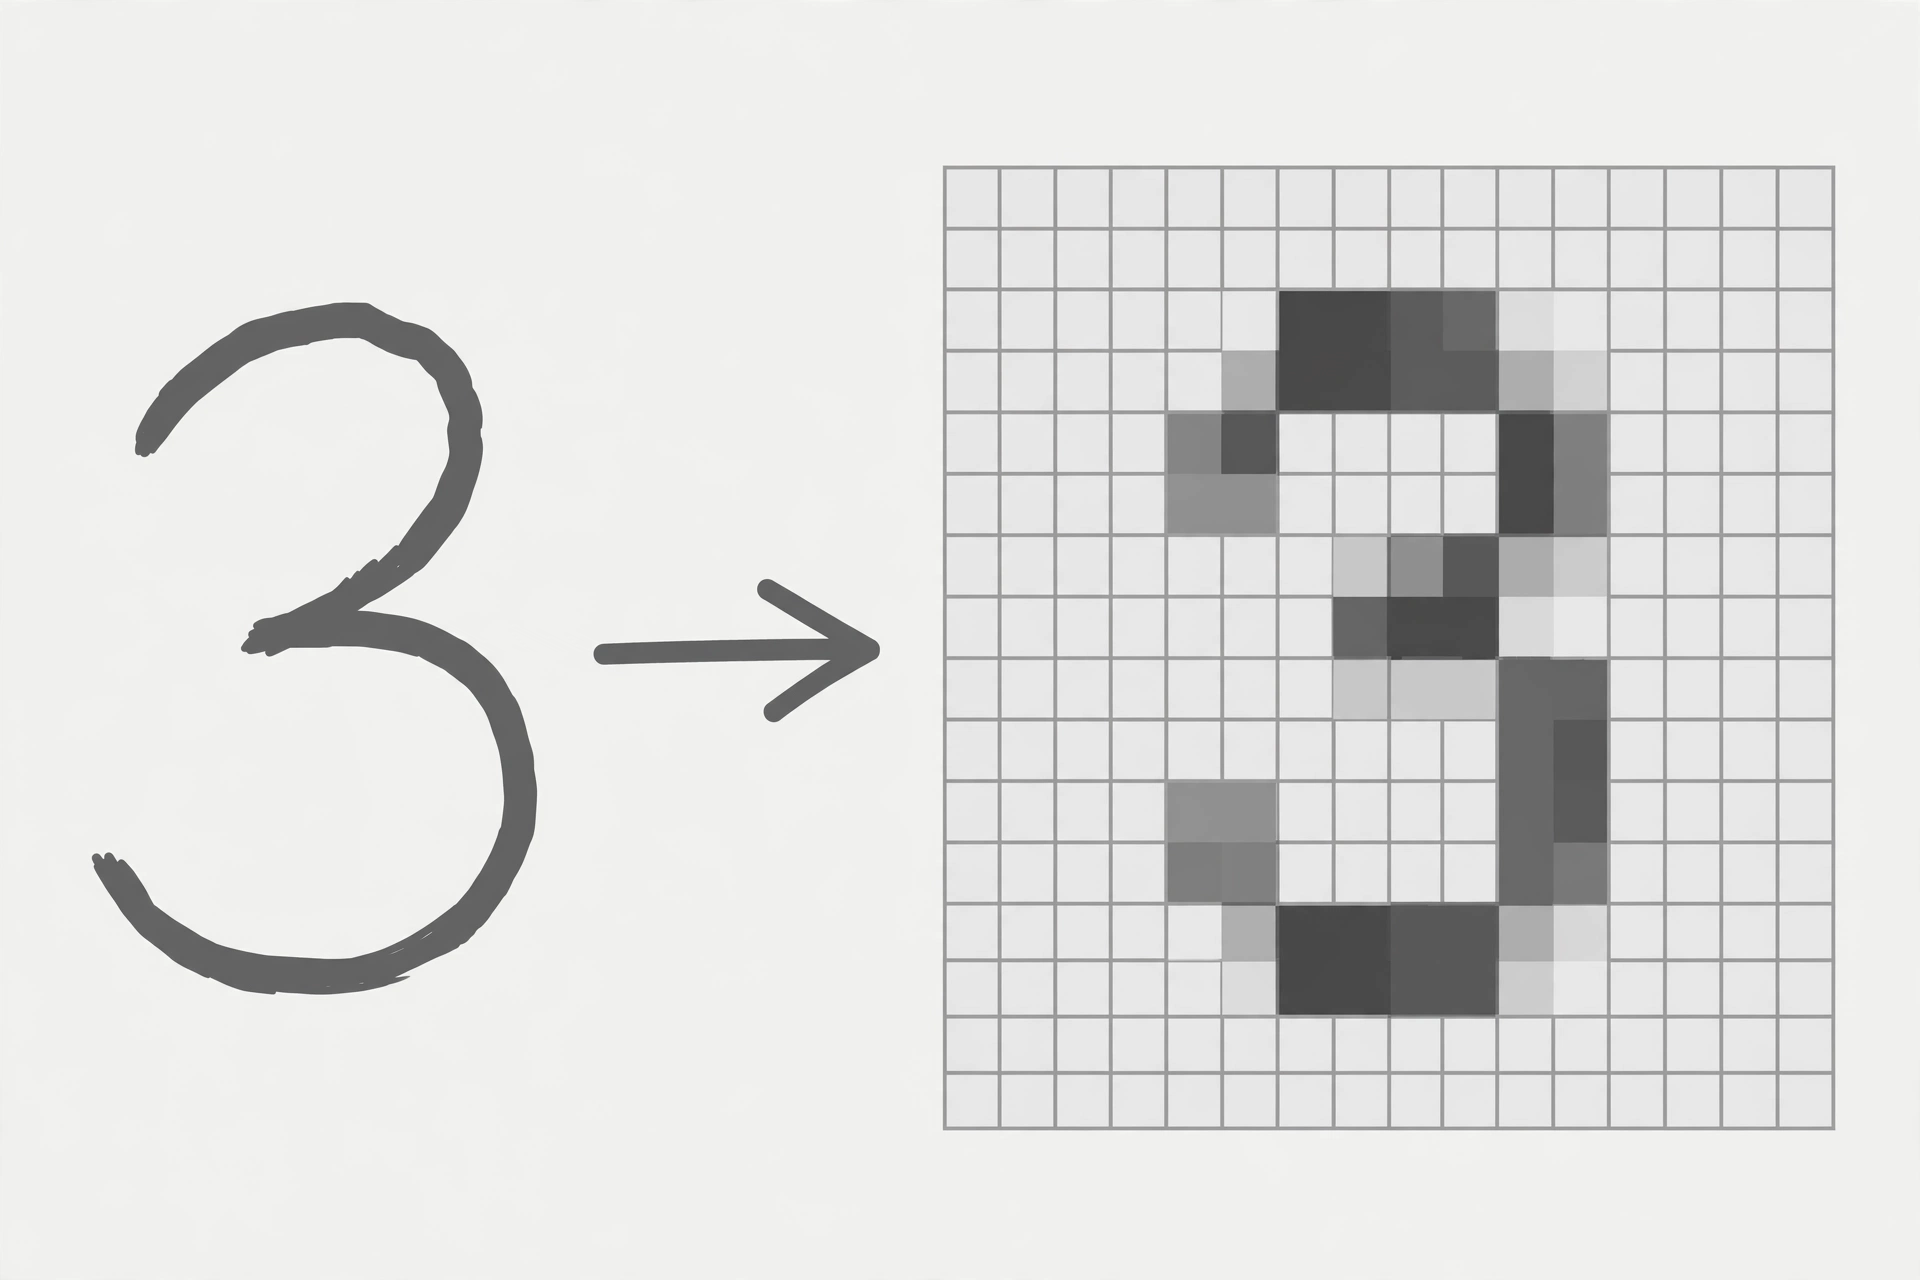
MNIST는 Modified National Institute of Standards and Technology의 약자로, 미국 표준기술연구소(NIST)의 손글씨 숫자 데이터를 다듬어 만든 데이터셋입니다. 1990년대 Yann LeCun, Corinna Cortes, Christopher J.C. Burges가 만들었고, 지금도 이미지 분류 알고리즘의 표준 벤치마크로 쓰입니다.
| 항목 | 내용 |
|---|---|
| 전체 이미지 | 70,000장 |
| 이미지 크기 | 28 × 28 픽셀 (흑백) |
| 클래스 | 숫자 0~9 (10개) |
| 훈련 / 테스트 | 60,000장 / 10,000장 |
| 과제 형태 | 지도학습 — 이미지에 정답 숫자(레이블)가 붙어 있는 분류 문제 |
2. 왜 MNIST인가
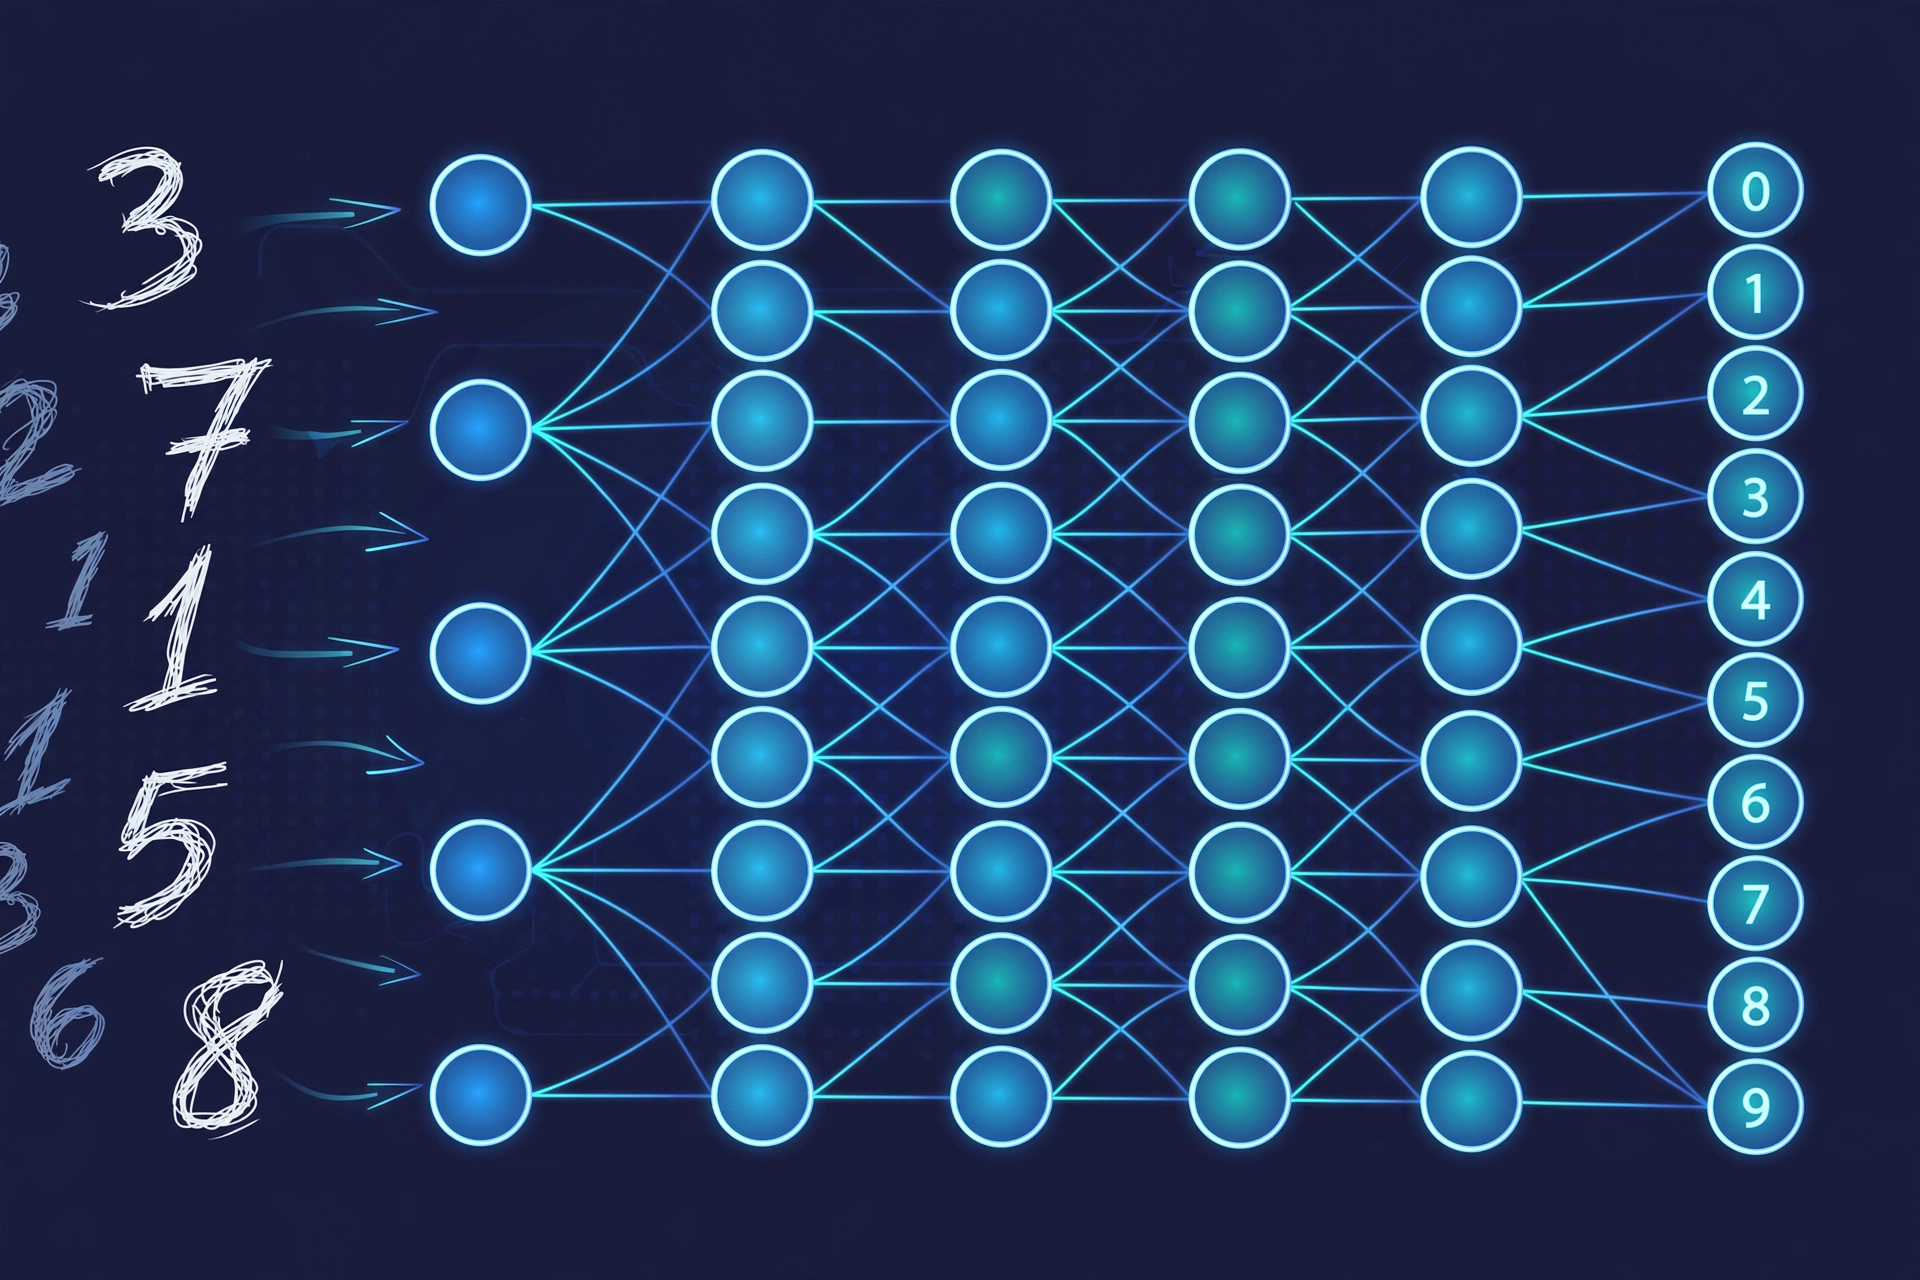
새로운 분류 알고리즘을 만들었을 때, 제일 먼저 돌려보는 게 MNIST입니다. 데이터가 작고 깨끗해서 몇 분 안에 결과를 확인할 수 있고, 전 세계 연구자가 같은 데이터로 겨루니 공정한 성능 비교가 가능합니다. 로지스틱 회귀부터 CNN까지, 거의 모든 분류 모델이 이 데이터셋을 거쳐 갑니다.
참고로 MNIST는 정답 레이블이 있는 지도학습(supervised learning) 데이터셋입니다. 로지스틱 회귀, 서포트 벡터 머신, 신경망 같은 분류 알고리즘을 평가하는 데 쓰입니다.
3. 실전: 직접 돌려본 MNIST 분류
아래는 실제로 실행한 결과입니다. scikit-learn의 로지스틱 회귀로 5,000장만 학습시키고 65,000장에 테스트했습니다.
from sklearn.datasets import fetch_openml
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

# MNIST 불러오기 (70,000장, 28x28)
X, y = fetch_openml("mnist_784", version=1, return_X_y=True, parser="auto")
X = X.to_numpy() / 255.0
y = y.astype(int).to_numpy()

# 5,000장만 학습용으로 분리
X_train, X_test, y_train, y_test = train_test_split(
    X, y, train_size=5000, random_state=42, stratify=y
)

model = LogisticRegression(max_iter=100)
model.fit(X_train, y_train)
print("테스트 정확도:", model.score(X_test, y_test))
# 결과: 0.895 (65,000장 기준)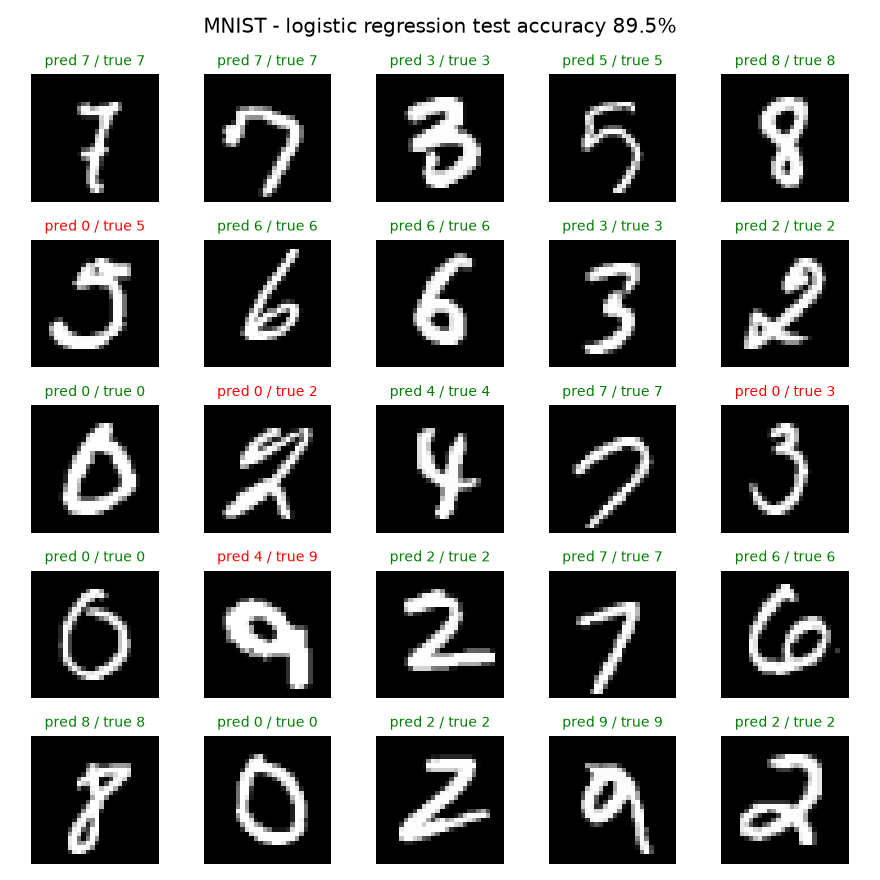
가장 단순한 선형 모델인데도 89.5%가 나왔습니다. 초록색은 정답, 빨간색은 오답인데, 보다시피 헷갈리게 쓴 숫자(5를 3처럼, 9를 4처럼 쓴 경우)에서 주로 틀립니다. CNN 같은 딥러닝 모델을 쓰면 99% 이상까지 올라갑니다.
4. MNIST로 시작하는 방법
파이썬과 scikit-learn만 있으면 바로 시작할 수 있습니다.
pip install scikit-learn matplotlib pandas위 실전 코드를 그대로 실행하면 같은 결과를 재현할 수 있습니다. fetch_openml("mnist_784") 한 줄로 70,000장을 내려받습니다. (최초 1회 다운로드에 시간이 걸릴 수 있습니다.)
마무리
MNIST는 작지만 머신러닝 분류의 모든 기본기를 담고 있는 데이터셋입니다. 데이터 불러오기 → 모델 학습 → 정확도 평가의 흐름을 이 한 장으로 익히면, 이후 어떤 이미지 분류 프로젝트에도 같은 패턴을 적용할 수 있습니다.
📎 관련 글: Iris Dataset은 무엇이지 — 숫자 대신 꽃의 품종을 분류하는 또 다른 대표 데이터셋입니다.