요즘 AI를 직접 내 PC에서 돌려보고 싶다는 생각을 하는 분들이 많습니다. ChatGPT처럼 대화하는 AI, Stable Diffusion 같은 이미지 생성 AI, 영상 생성 모델까지 이제는 개인 PC에서도 실행할 수 있습니다.
그런데 막상 시작하려고 보면 한 가지 벽을 만납니다.
“왜 AI 좀 돌리려는데 그래픽카드가 이렇게 비싸지?”
게임을 하지 않는 사람이라면 더 이상합니다. 그래픽카드는 원래 게임 화면을 예쁘게 보여주는 장치라고 생각했는데, 왜 인공지능 시대가 되자 갑자기 가장 중요한 부품이 되었을까요?
결론부터 말하면, AI는 ‘엄청난 양의 계산’을 동시에 처리해야 하기 때문입니다
CPU는 매우 똑똑한 만능 사무원에 가깝습니다. 복잡한 일을 순서대로 처리하는 데 강합니다. 반면 GPU는 수천 명의 계산원이 한꺼번에 같은 종류의 계산을 처리하는 구조입니다.
AI의 핵심 연산은 대부분 거대한 행렬 계산입니다. 숫자 수백만 개를 곱하고 더하는 작업이 반복됩니다. 이런 작업에서는 CPU보다 GPU가 훨씬 효율적입니다.
그래서 GPU는 게임용 부품에서 시작했지만, 지금은 AI 연산의 핵심 엔진이 되었습니다.
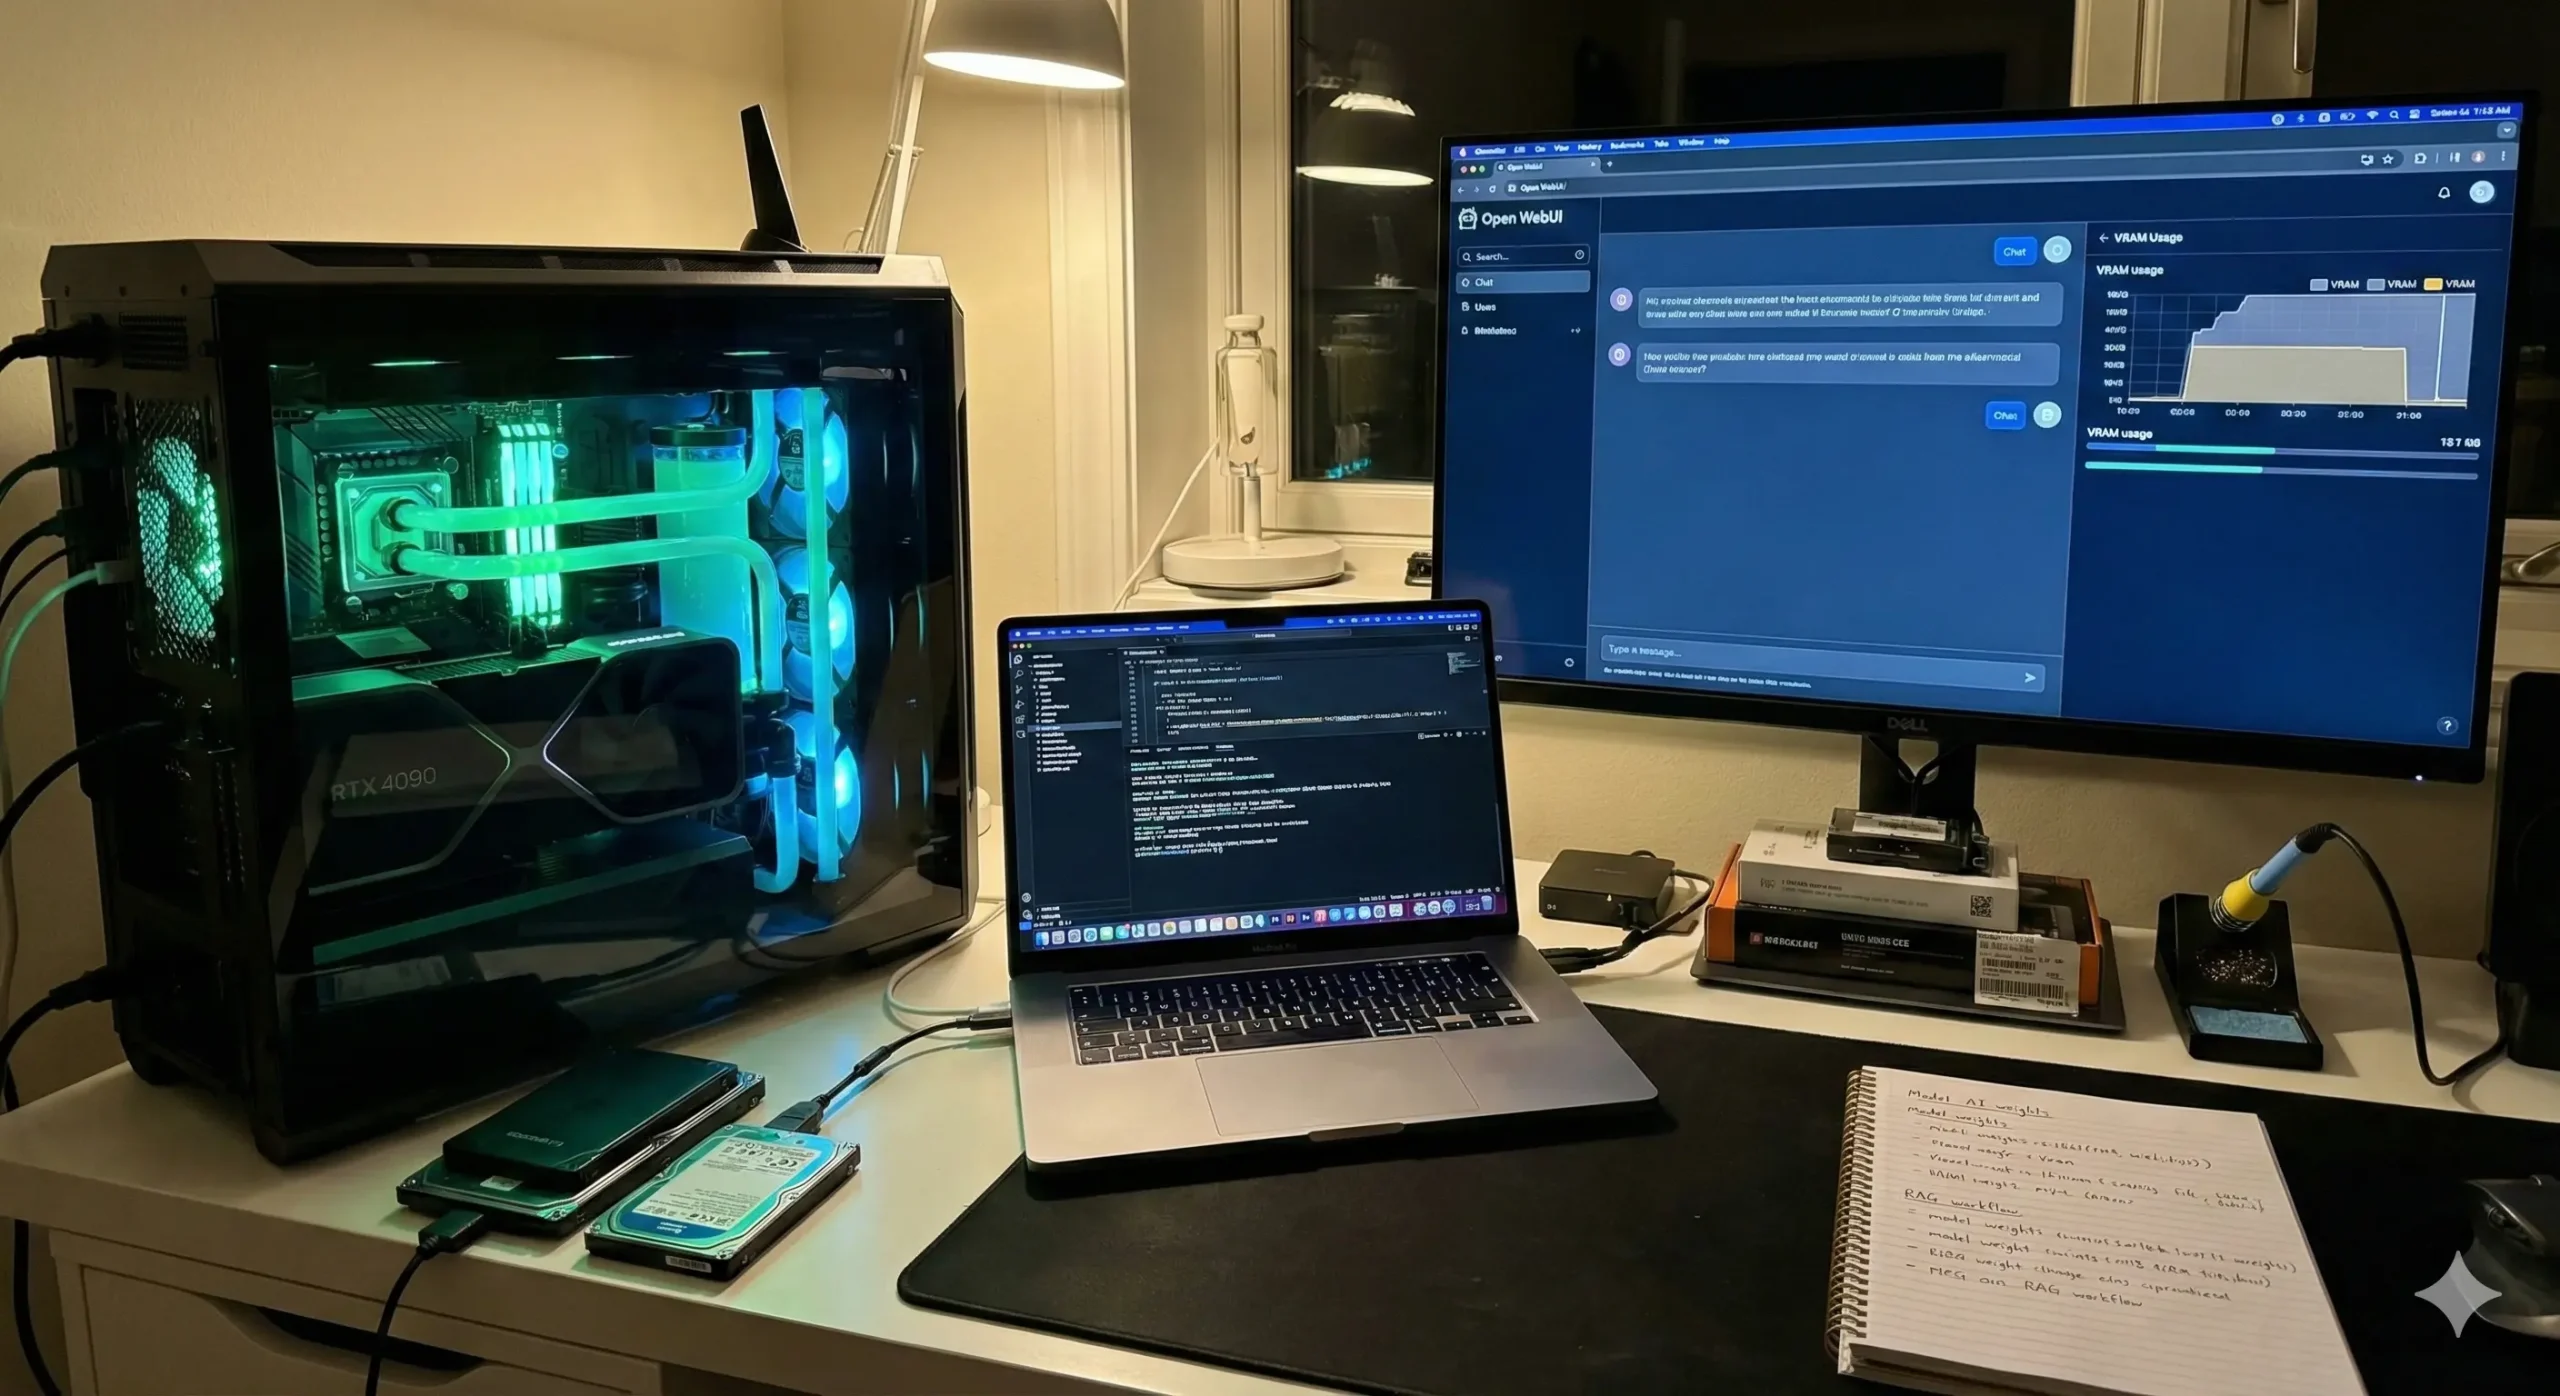
그런데 GPU 성능보다 더 중요한 것이 있습니다. 바로 VRAM입니다
로컬 AI를 처음 시작할 때 많은 분들이 CUDA 코어 수, 클럭, 벤치마크 점수만 봅니다. 하지만 실제로 AI를 실행하다 보면 먼저 부딪히는 한계는 종종 VRAM 용량입니다.
VRAM은 그래픽카드 안에 붙어 있는 전용 메모리입니다. 게임에서는 고해상도 텍스처, 프레임 버퍼 등을 저장하고, AI에서는 모델의 가중치와 연산 중 필요한 데이터를 담습니다.
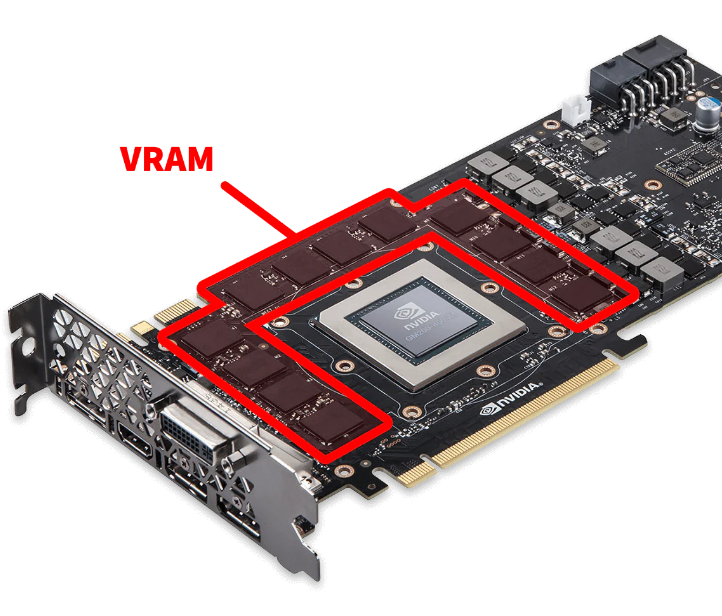
NVIDIA는 VRAM을 GPU가 빠르게 접근할 수 있는 고속 메모리라고 설명합니다. 게임뿐 아니라 생성형 AI에서도 VRAM 크기는 실행 가능한 모델 크기와 직결됩니다.
AI 모델은 사실 ‘거대한 숫자 덩어리’입니다
LLM에서 자주 보는 7B, 13B, 70B 같은 숫자는 모델의 파라미터 수를 뜻합니다. 예를 들어 7B 모델은 약 70억 개의 파라미터를 가진 모델입니다.
이 숫자들을 메모리에 올려야 AI가 계산을 시작할 수 있습니다.
예를 들어 FP16 형식에서는 파라미터 하나에 약 2바이트가 필요합니다. 단순 계산으로만 보면 70억 개라면 약 14GB입니다. 여기에 실행 중 필요한 추가 메모리까지 포함되면 요구량은 더 커집니다.
NVIDIA 기술 문서에서도 7B 모델을 FP16으로 실행하거나 학습하는 경우 상당한 GPU 메모리가 필요하다고 설명합니다.
그래서 8GB 그래픽카드에서는 실행하기 어려운 모델이 16GB에서는 돌아가고, 24GB 이상에서는 훨씬 여유롭게 동작하는 상황이 생깁니다.
그런데 여기서 궁금해집니다. “7B가 정확히 뭐고, 내가 가진 그래픽카드로는 몇 B까지 돌릴 수 있을까?” 이 부분은 별도의 입문 글에서 7B·13B·70B, FP16과 4bit 양자화, VRAM 계산법부터 Hugging Face에서 실제 모델을 내려받는 방법까지 이어서 정리했습니다. 7B·13B·70B는 무슨 뜻일까? 내 그래픽카드로 돌릴 수 있는 AI 모델 찾기
VRAM은 책상 크기라고 생각하면 쉽습니다
AI 모델을 거대한 설계도라고 생각해보겠습니다.
VRAM은 그 설계도를 펼쳐놓는 책상입니다.
책상이 충분히 크면 모든 자료를 한 번에 펼쳐놓고 빠르게 작업할 수 있습니다. 하지만 책상이 좁으면 자료를 계속 서랍에 넣었다 꺼내야 합니다.
AI에서도 비슷합니다. 모델이 VRAM에 전부 올라가지 않으면 일부 데이터를 시스템 RAM이나 CPU 쪽으로 넘겨야 합니다. 이것을 GPU Offloading이라고 부릅니다.
실행은 가능해질 수 있지만 속도는 크게 느려질 수 있습니다.
게임에서 VRAM이 중요했던 이유가 AI에서도 그대로 이어집니다
고사양 게임에서도 4K 해상도, 고해상도 텍스처, 레이트레이싱을 사용하면 VRAM 사용량이 크게 증가합니다.
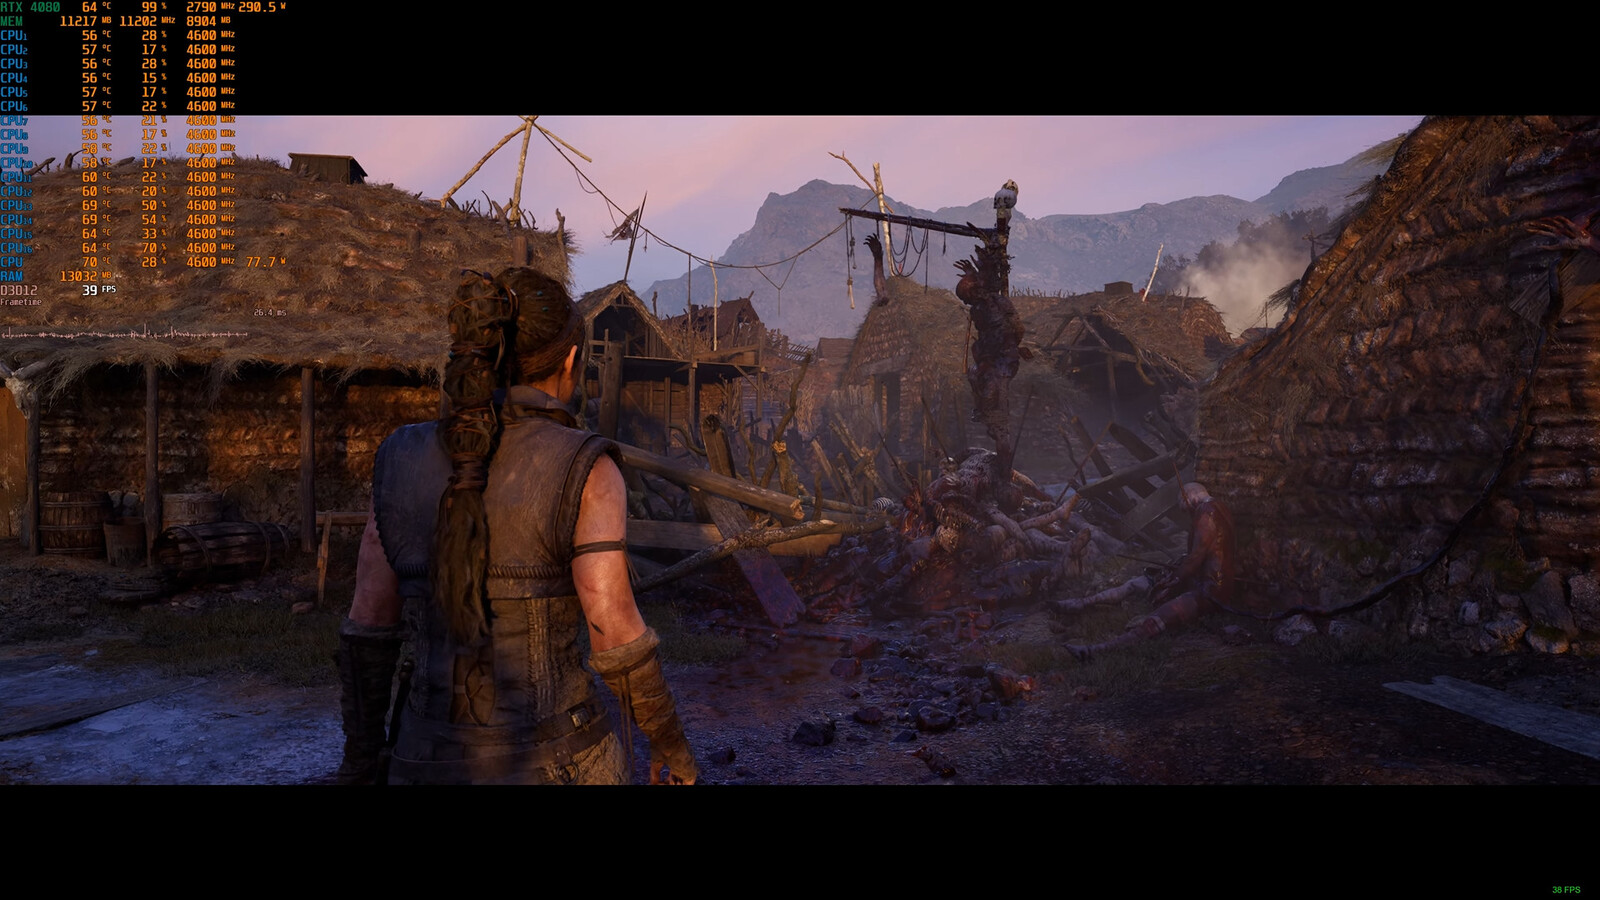
AI 역시 마찬가지입니다. 다만 게임이 텍스처와 프레임 데이터를 올린다면, AI는 수십억 개의 파라미터를 올린다는 차이가 있습니다.
즉 게임 시대에 GPU가 ‘화면을 만드는 엔진’이었다면, AI 시대에는 ‘생각을 계산하는 엔진’ 역할까지 맡게 된 셈입니다.
그래서 NVIDIA가 AI 시대의 핵심 기업이 되었습니다
GPU는 원래 그래픽 처리용으로 발전했지만, 병렬 연산이라는 특성이 딥러닝과 매우 잘 맞았습니다. NVIDIA는 CUDA 생태계를 통해 개발자가 GPU를 AI 연산에 활용하기 쉽게 만들었습니다.

이 때문에 오늘날 PyTorch, TensorFlow, Stable Diffusion, LLM 추론 도구 등 수많은 AI 소프트웨어가 NVIDIA GPU에 최적화되어 있습니다.
그렇다면 무조건 가장 비싼 그래픽카드를 사야 할까요?
그렇지는 않습니다. 중요한 것은 내가 어떤 AI를 돌릴 것인가입니다.
- 가벼운 로컬 LLM: 8GB~12GB VRAM에서도 양자화 모델을 활용하면 충분히 경험할 수 있습니다.
- Stable Diffusion, SDXL: 12GB~16GB 정도면 꽤 편하게 사용할 수 있습니다.
- 조금 더 큰 LLM, 이미지 생성, 영상 생성: 16GB 이상이 확실히 유리합니다.
- 대형 LLM, 학습, 고해상도 영상 생성: 24GB 이상 또는 여러 GPU가 필요할 수 있습니다.
최근에는 4비트, 8비트 양자화를 이용해 모델 크기를 크게 줄일 수 있습니다. 덕분에 과거에는 24GB VRAM이 필요했던 모델을 더 적은 메모리에서도 실행할 수 있습니다.
CPU와 RAM이 많으면 GPU 없이도 가능하지 않을까요?
가능합니다.
실제로 llama.cpp 같은 도구는 CPU만으로도 LLM을 실행할 수 있습니다. Apple Silicon처럼 통합 메모리를 사용하는 시스템도 로컬 AI에서 상당히 매력적입니다.
하지만 속도 차이는 분명합니다.
AI에서 중요한 것은 단순히 “돌아가느냐”가 아니라 얼마나 빠르게 결과가 나오느냐입니다.
이미지 한 장을 만드는 데 5초가 걸리는 것과 2분이 걸리는 것은 체감이 완전히 다릅니다. 영상 생성에서는 이 차이가 몇 분과 몇 시간으로 벌어질 수도 있습니다.
그래픽카드 가격이 비싼 진짜 이유
결국 우리가 비싼 GPU를 사는 이유는 단순히 FPS를 높이기 위해서가 아닙니다.
GPU에는 다음과 같은 요소가 동시에 들어갑니다.
- 수천 개의 병렬 연산 코어
- AI 전용 Tensor Core
- 고속 VRAM
- 매우 높은 메모리 대역폭
- 복잡한 전력 및 냉각 설계
특히 VRAM은 단순한 저장 공간이 아닙니다. GPU가 초당 수백 GB 이상의 데이터를 주고받을 수 있도록 설계된 매우 빠른 메모리입니다.
로컬 AI의 가장 큰 장점은 ‘내 컴퓨터에서 돌아간다’는 것입니다
그렇다면 클라우드 AI를 쓰면 되지 않을까요?
물론 대부분의 사람에게는 ChatGPT, Gemini, Claude 같은 서비스가 훨씬 편합니다.
하지만 로컬 AI에는 분명한 장점이 있습니다.
- 인터넷 없이 사용할 수 있습니다.
- 개인 데이터가 외부 서버로 나가지 않습니다.
- API 비용을 계속 지불하지 않아도 됩니다.
- 모델을 자유롭게 수정하고 실험할 수 있습니다.
- 자동화 시스템과 직접 연결하기 쉽습니다.
특히 개발자나 AI를 직접 연구하고 싶은 사람에게 로컬 AI는 하나의 작은 개인 연구실이 됩니다.
초보자가 그래픽카드를 고를 때는 ‘성능’보다 VRAM부터 보세요
로컬 AI를 목적으로 그래픽카드를 구입한다면 다음 순서로 보는 것이 좋습니다.
- VRAM 용량
- CUDA 및 AI 소프트웨어 호환성
- Tensor Core 세대
- 메모리 대역폭
- 전력 소비와 가격
게임 벤치마크에서 조금 더 빠른 GPU보다 VRAM이 더 많은 GPU가 AI에서는 오히려 더 유용한 경우가 많습니다.
마무리: AI 시대의 그래픽카드는 새로운 형태의 컴퓨터입니다
과거에는 좋은 그래픽카드를 사는 이유가 분명했습니다.
게임을 더 높은 해상도와 더 높은 FPS로 즐기기 위해서였습니다.
하지만 AI 시대에는 의미가 달라졌습니다.
그래픽카드는 이제 단순히 화면을 그리는 장치가 아니라 이미지 생성, 영상 생성, 음성 합성, LLM 추론까지 담당하는 작은 병렬 컴퓨터가 되었습니다.
그리고 그 컴퓨터의 작업 공간이 바로 VRAM입니다.
그래서 로컬 AI를 시작하면 자연스럽게 이런 생각을 하게 됩니다.
“GPU가 얼마나 빠른가?”보다 먼저 “VRAM이 얼마나 큰가?”
아마 AI를 직접 돌려본 사람이라면 이 말이 꽤 빠르게 이해될 것입니다.
핵심 키워드: 로컬 AI, GPU, VRAM, 그래픽카드, LLM, Stable Diffusion, 생성형 AI, NVIDIA, CUDA
핑백: RTX 4070 Ti SUPER로 로컬 AI 돌리기 | LM Studio·GGUF 가이드